Architektur &
Entkopplung
Optionale KI in arsnova.eu
bei reaktionsfähigem
Live-Betrieb
Thema 1 · 1A / 1B / 1C
Cloud Computing · Stand: 13.
November 2026
Fragestellung und Arbeitsumfang
Wie bleibt arsnova.eu bei optionaler KI reaktionsfähig?
Ressourcen auf dem Applikationshost
spaCy begrenzen; Latenz und Ablehnungen unter gleicher Last messen.
Separater privater Inferenzserver
LLM-Aufrufe räumlich trennen; private Ziele, Zugang und belegte Slots prüfen.
Autorisierter Kontext und asynchroner Adapter
Berechtigte Quellen vorbereiten; im Hintergrund verarbeiten; vor Ausgabe erneut prüfen.
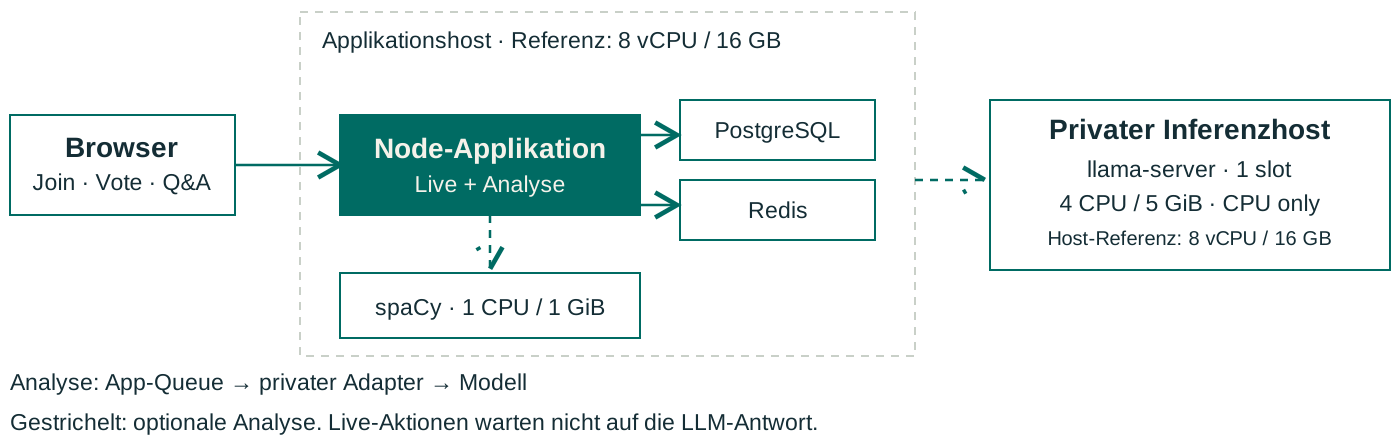
Systemgrenzen der Referenzarchitektur
Live-Aktionen und optionale Analysen haben unterschiedliche Ausführungspfade.
Versuchsaufbau und Belegarten
Ein unveränderter Ausgangsstand; zwei getrennte Laboraufbauten.
1A · Lokale Ressourcen
ARM64-Docker-VM: 10 logische CPUs, ca. 7,65 GiB RAM.
Backend: 4 CPU / 3 GiB. spaCy auf demselben VM-Host.
1B / 1C · Reale Inferenz
Laptop-App → separater geteilter Ryzen-Server.
CPU-Laufzeit: 4 CPU / 5 GiB, 1 Slot. RTX 3060 ausgeschlossen.
Quellcodeprüfung ≠ Mock-Test ≠ realer Modelllauf. Die Labore entsprechen nicht der Referenzhardware.
1A · Wiederholbarer Ressourcenvergleich
Gleicher Fragenkorpus und gleiche angebotene Last in neun gültigen Läufen.
spaCy aus
Identitätstokens statt Lemmatisierung.
1 CPU / 1 GiB
Normales Budget für den NLP-Sidecar.
0,25 CPU / 1 GiB
CPU begrenzt; RAM unverändert.
Pro Lauf
100 feste Fragen
30 Analysen · 1 Anfrage/s
720
Quiz-Votes
54 Beitritte · 24 Q&A-Submits
3 Wiederholungen je Zustand; Reihenfolge gegenbalanciert. Modelle warm, Text-/Snapshot-Caches kalt.
1A · Live-Latenz im getesteten Lastprofil
Alle neun Läufe erfüllten die vorgeschlagenen lokalen Latenzgrenzen.
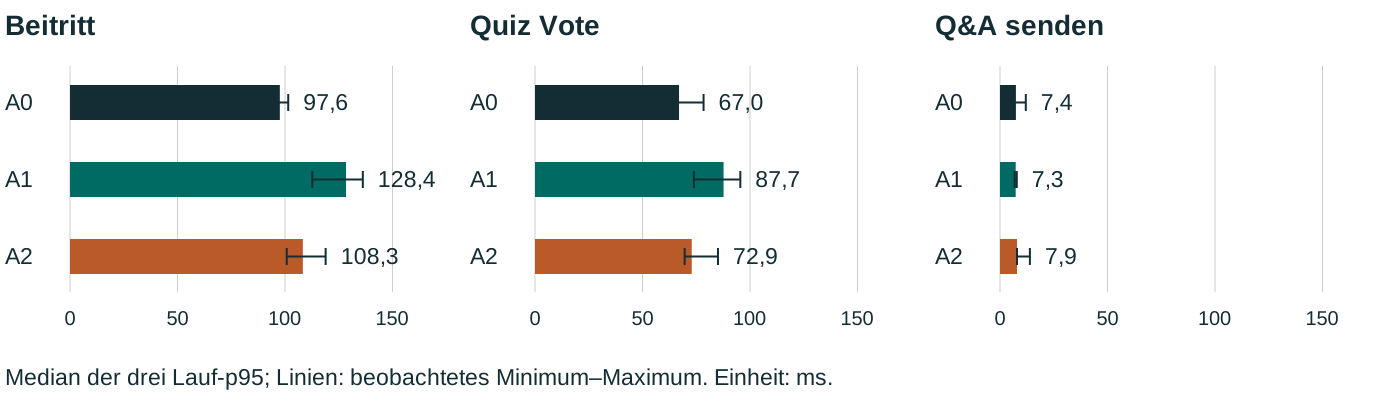
Lokale Prüfschwellen: Vote-p95 ≤ 250 ms; Join-/Submit-p95 ≤ 500 ms. Keine offiziellen Produktions-SLOs.
1A · Weniger CPU verlängert die Analyse
Bei 0,25 CPU steigen die Latenz angenommener Anfragen und die Busy-Ablehnungen.
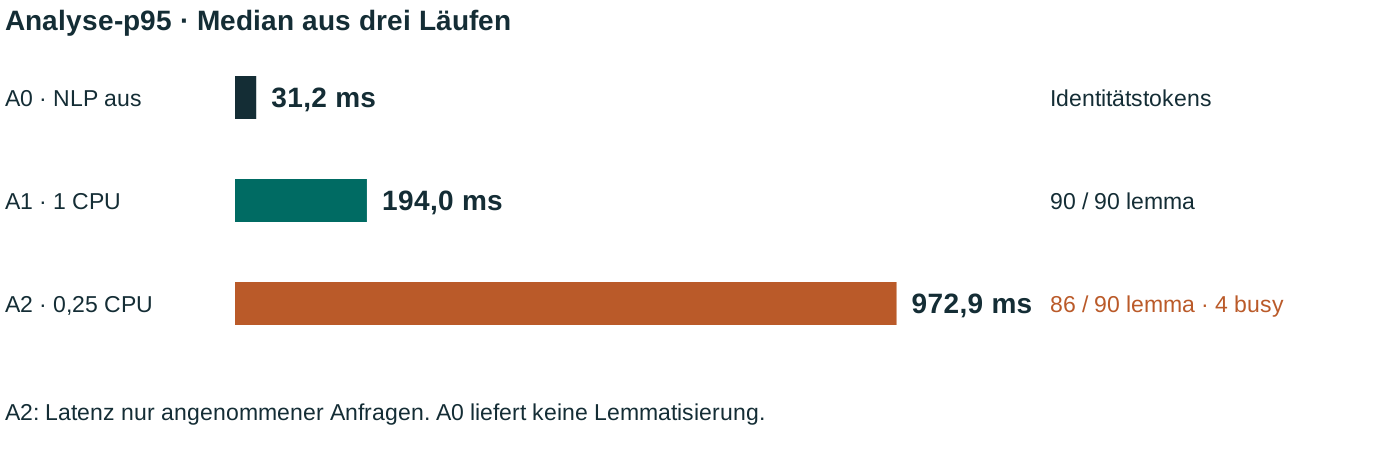
1 CPU / 1 GiB für dieses Lastprofil beibehalten. NLP abzuschalten ist eine funktionale Alternative mit anderem Sprachergebnis.
1B · Tatsächlich gemessene Inferenzrolle
Privater Zugriff auf einen getrennten CPU-Prozess; vorhandene GPU nicht genutzt.
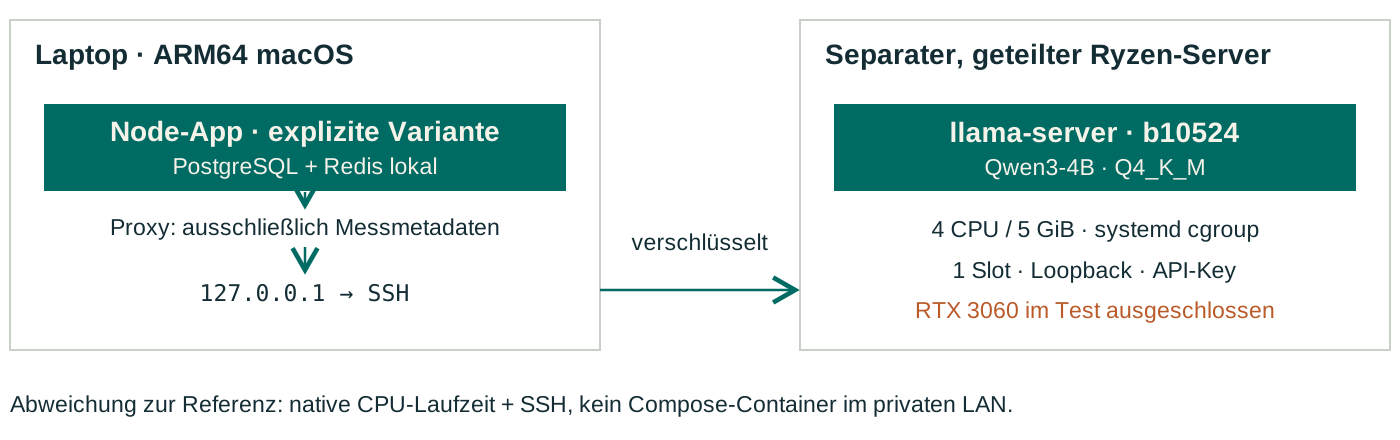
1B · Lange Inferenz bei laufender Q&A
Die explizite Variante lieferte sechs quellengebundene Aussagen nach rund zwei Minuten.
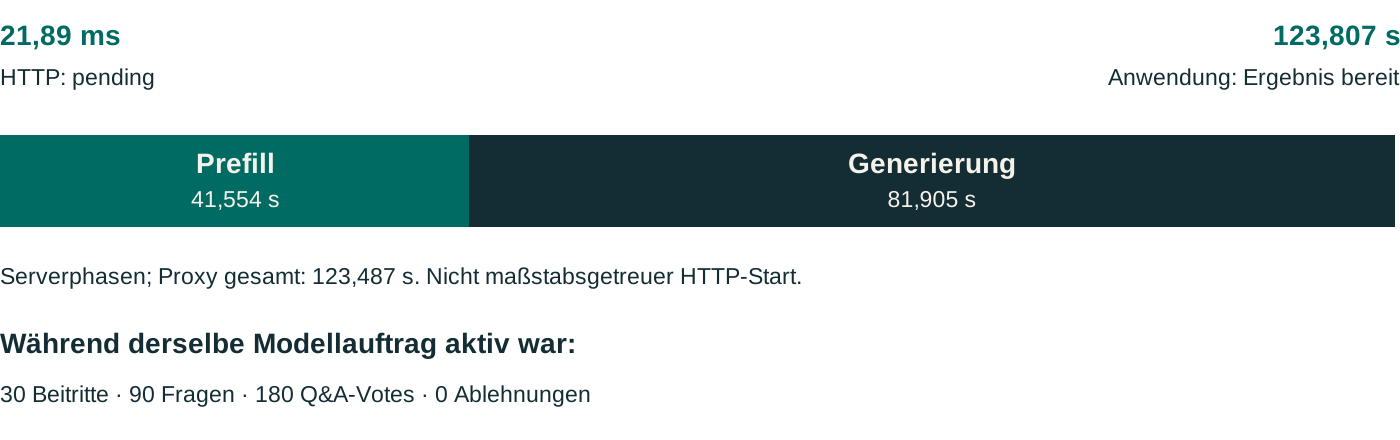
1C · Autorisierter Kontext und Hintergrundarbeit
pending kommt vor dem Modellergebnis, aber nach der ersten Kontextvorbereitung.
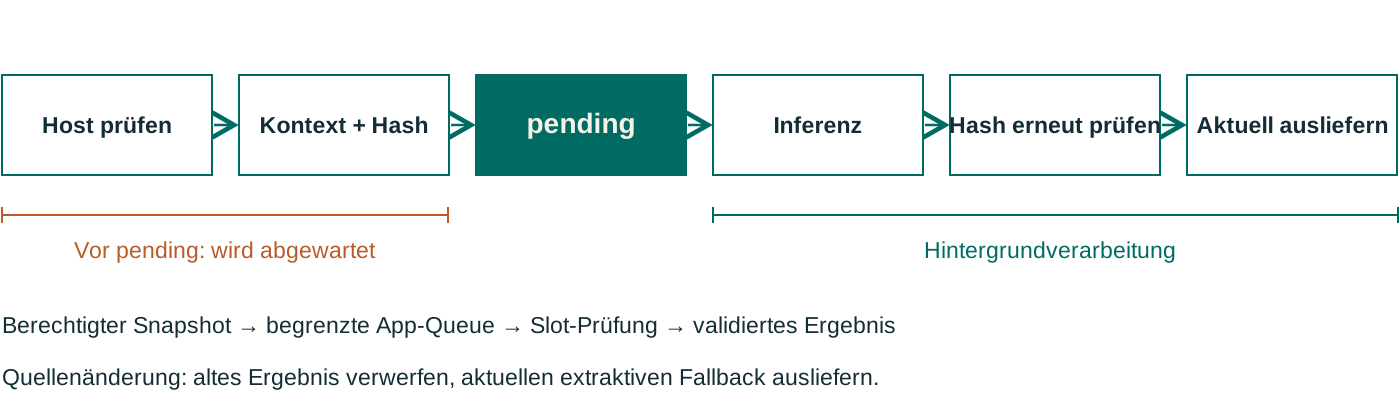
Begrenzte App-Queue und belegter Modellslot sind zwei verschiedene Zulassungsgrenzen.
1C · Quellenlöschung während der Inferenz
Ein teures altes Ergebnis darf den aktuellen Quellenstand nicht überschreiben.
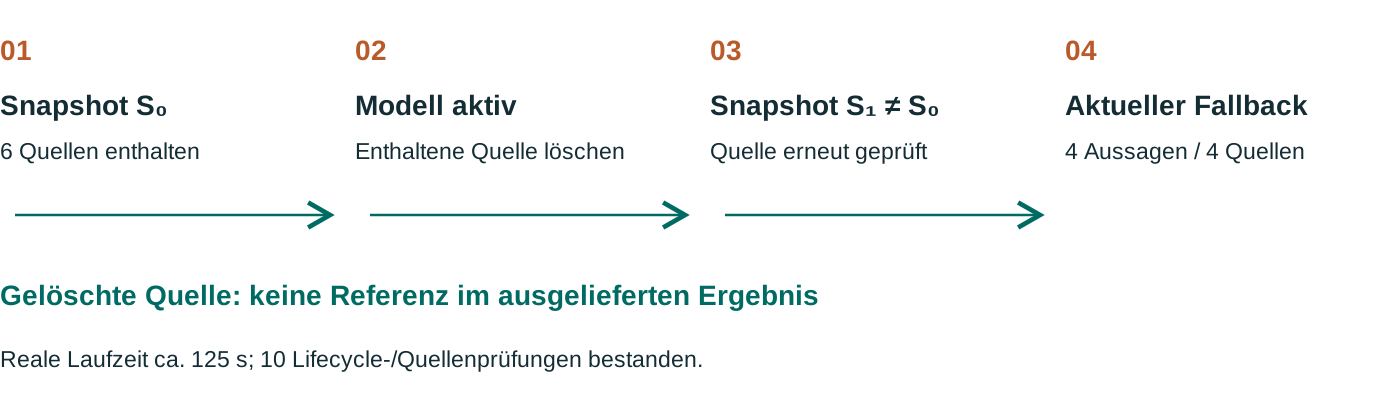
Ausgangsstand und Experiment
Ein erfolgreicher Lebenszyklus ist noch keine brauchbare generative Zusammenfassung.
| Unveränderte Basis | Explizites Experiment | |
|---|---|---|
| Packing-Profil | 4096 | 8192 |
| Summary-Timeout | 8 s | 180 s |
| Berücksichtigte Quellen | 0 / 6 | 6 / 6 |
| Reales Endergebnis | Timeout-Fallback · 0 Aussagen | full-context · 6 Aussagen |
| Zeit bis Endergebnis | ca. 8,23 s | 123,807 s |
Der 4096-Packer verwendet eine konservative UTF-8-Byte-Obergrenze. Das sind keine gemessenen Modell-Tokenzahlen.
Aussagegrenzen und nächste Messung
Die Befunde tragen eine Laborentscheidung; sie belegen noch keine Produktionskapazität.
Andere Hardware und TopologieARM64-VM bzw. geteilter Ryzen-Host; SSH statt direktem privatem LAN.
Begrenzte Wiederholungen1A: drei Läufe je Zustand. 1B/1C: gezielte reale Nachweise, keine Kapazitätsstudie.
Qualität bleibt offenSchema und Quellen-IDs bestätigen keine semantische Richtigkeit.
Nächster KontrollversuchInferenz idle/aktiv/begrenzt/gestört vergleichen; Slot-Freigabe nach Abbruch real messen.
Betriebsentscheidung
Vorläufige Empfehlung für die tatsächlich geprüften Profile.
spaCy bei 1 CPU / 1 GiB belassen
Bei geringerer CPU Lasttakt oder akzeptierte Wartezeit neu festlegen.
Private Inferenzrolle und Quellenprüfung beibehalten
Live-Aktionen vom Modellergebnis entkoppeln; veralteten Output verwerfen.
Generative Funktion vorerst deaktiviert lassen
Kontext, Frische und Qualität begründen, bevor die Variante übernommen wird.
Anhang · 1A im Detail
Lauf-p95 in ms: Median aus drei Wiederholungen; Klammern zeigen Min–Max.
| Zustand | Join | Quiz Vote | Q&A senden | Analyse | Lemma / busy |
|---|---|---|---|---|---|
| A0 | 97,6 (96,6–101,5) | 67,0 (64,0–78,4) | 7,4 (6,3–12,0) | 31,2 (26,3–39,4) | 0 / 0 |
| A1 | 128,4 (112,7–136,2) | 87,7 (73,9–95,5) | 7,3 (6,8–7,8) | 194,0 (193,9–206,3) | 90 / 0 |
| A2 | 108,3 (100,8–118,9) | 72,9 (69,6–85,1) | 7,9 (7,9–13,9) | 972,9 (886,5–1057,5) | 86 / 4 |
Pro Zustand: 2160 Quiz-Votes, 162 Beitritte, 72 Q&A-Submits. Keine Live-Vote-/Submit-Fehler.
RAM-Stichproben: App max. 478,5 MiB; spaCy max. 486,7 MiB. Keine OOMs oder Neustarts während der Messung.
Ungültiger Tokenablauf-Lauf vollständig ersetzt; ursprünglicher Bericht bleibt erhalten.
Anhang · Reproduzierbarkeit und Quellen
Code, Konfiguration und Rohberichte bilden gemeinsam den Beleg.
Release-Quellcode und ADR-0035v1.3.0 ·
87c39334619fbcb0c5782b061da1ba0df0ba3142
1A-Protokoll, Rohdaten und TabelleFixer Korpus · kalte Text-Caches · gegenbalancierte Reihenfolge
1B/1C-Laufzeit und reale Modellberichtellama.cpp b10524 · Qwen3-4B-Instruct-2507-Q4_K_M.gguf
Expliziter Patch und Grenzen8192-Packing + 180-s-Timeout; keine Produktionsfreigabe
Anhang · KI-Hilfe und Eigenleistung
Die Unterstützung wird offengelegt; die fachliche Verteidigung bleibt eigenständig.
Mit Codex erstellt
Planung, Quellcodeprüfung, Harnesses, Auswertung und Entwurf dieser Folien.
Titelillustration mit Image Gen. Diagramme und Charts aus dokumentierten Abläufen und Messdaten.
Vor Abgabe selbst prüfen
Belege lesen, Varianten erklären und Grenzen der Aussagen begründen.
Kurs-Commit und formale Vorgaben bestätigen. Keine behauptete unabhängige Eigenmessung ohne Hinweis auf die Hilfe.
Alle verwendeten Messzahlen sind beobachtete Laborwerte. KI-generierte Illustration ist kein Foto des Versuchs.